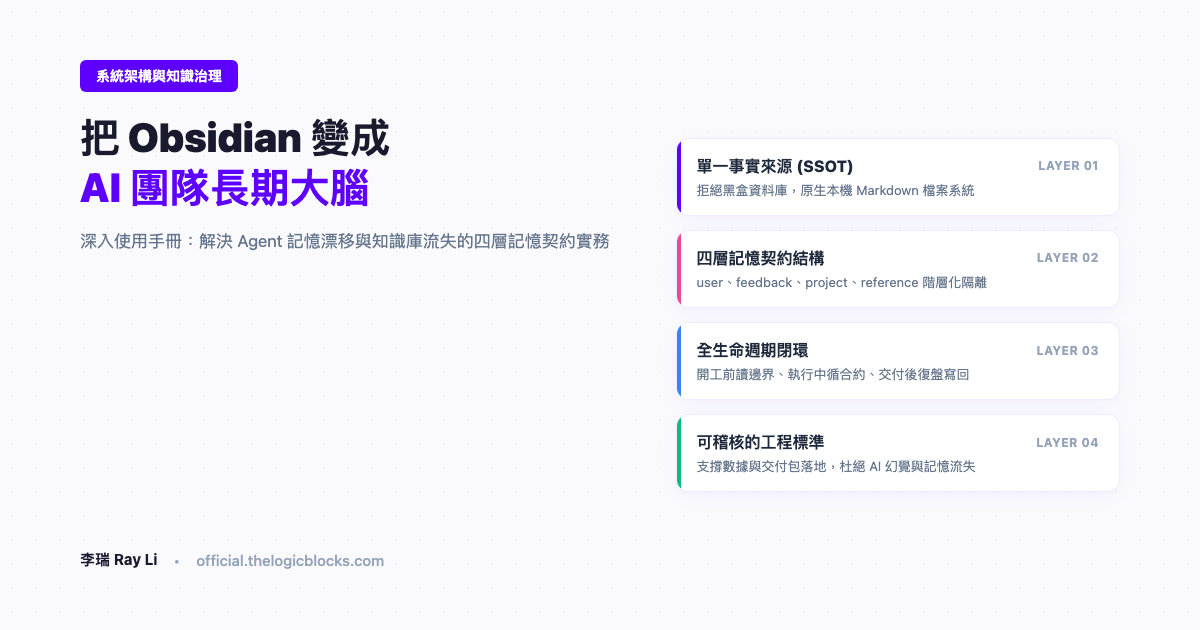
許多工程師與創作者在使用 AI 時常遇到共同的挫折:對話視窗拉長後 AI 就開始胡說八道,開個新對話又得重新交代背景;或是多個 Agent 並行時彼此打架、甚至推翻先前定案的商業決策。這不是模型智商問題,而是缺少單一事實來源(Single Source of Truth, SSOT)的治理中樞。本文公開我們如何將 Obsidian 深度打造成 AI 團隊的長期記憶大腦與協同工作流。
先講結論:別把 Obsidian 當「筆記軟體」,它是「AI 的只讀中樞與可稽核檔案系統」
市面上 99% 的 Obsidian 教學都在教漂亮的雙向連結圖譜、Dataview 炫技或卡片盒筆記法(Zettelkasten)。但當你進階到讓 AI Agent(如 Claude Code, Hermes Agent, 自建 Agent Team)參與日常業務與研發時,Obsidian 的核心定位必須徹底重構:
- 純純的本機 Markdown 檔案系統:沒有任何專有資料庫鎖定,任何終端 CLI、Python 腳本或 AI 爬蟲都能原生零成本讀寫。
- 可稽核的長期記憶(Auditable Long-term Memory):AI 不是隨意把東西存在雲端 Blackbox,而是每次決策、每次業務踩坑都實體落盤成可版本控管的文檔。
- 商業與工程的最高信任錨點:專案程式碼可以分散在各個 Git repo,但所有客戶交付物、數據支撐證據與決策規則,必須在 Obsidian 內查得到;查不到,在團隊標準中就等於「不存在」。
AI 記憶失控的三大真實病徵
在深入系統設定前,先檢視你的工作流是否出現以下「Agent 漂移」現象:
| 病徵 | 具體現象 | 根本原因 | 傳統解決方案的致命盲點 |
|---|---|---|---|
| 1. 脈絡漂移 (Context Drift) | 聊到第 20 輪,AI 開始忘記第 3 輪講好的安全規範與命名原則 | 上下文長度擠壓、Token 壓縮時丟失細節 | 狂貼長 Prompt:浪費 Token、引發注意力分散 |
| 2. 決策精神分裂 (Split Personality) | 今天請 Agent A 做前端,明天 Agent B 接手時直接把架構推翻重寫 | 缺乏跨工作階段的跨 Session 記憶同步機制 | 每次對話手動複製貼上:極易遺漏且無維護性 |
| 3. 交付證據脫節 (Proof Orphan) | 報告寫得很漂亮,但幾週後回頭查找不到原始數據或評估依據 | 暫存資料散落在本機各目錄,未與結論綁定 | 「反正東西做完了」:日後客戶稽核或接交時直接開天窗 |
四層記憶契約架構:如何將 Obsidian 結構化?
為了讓 AI 能精確讀取且不被龐大雜訊干擾,我們在 Obsidian 內建立了一套標準的四層記憶分級體系(Memory Contract):
Obsidian Vault/
├── Claude/ (或 AgentOS/)
│   ├── Rules.md          # 記憶寫入規範與行為憲法
│   ├── INDEX.md          # 全域記憶總索引(AI 進場第一張地圖)
│   ├── Memory/           # 永久事實記憶庫 (Long-term Facts)
│   │   ├── user_*.md     # 人設與原則:決策風格、核心業務邊界
│   │   ├── feedback_*.md # 踩坑教訓:明確的 DO / DO NOT 與原因
│   │   ├── project_*.md  # 專案現況:架構定案、交付物索引
│   │   └── reference_*.md# 外部系統指針:Lark, Notion, API 金鑰規範
│   └── Inbox/            # 待驗證記憶暫存區 (Staging Area)
├── 營運/ & 產品/         # 業務交付與真實案例支撐庫
└── 每日紀錄/             # 時間戳流水帳 (Daily Logs)
1. user_*:人設與不可動搖的決策邊界
記錄創辦人或團隊的硬性邊界。例如:「專案部署一律走 Cloudflare $0 底層架構,只有特定客戶專案才進 Zeabur」、「拒絕任何未經驗證的罐頭行銷詞」。AI 每次決策前必先過濾此層。
2. feedback_*:教訓記憶(核心在於「Why」)
這是避免重複踩坑最關鍵的一環。純粹記錄「不要做 X」往往無效,必須包含具體的踩坑背景:
- 第一段:規則本體。
- Why:過往何時發生事故、客戶反應是什麼。
- How to apply:何種情境觸發此規則。
- 範例:記錄某次客戶報告中的原始 JSON 留在臨時目錄導致審查失敗的事件,強制規定未來所有數據報告必須將原始依據同步落地至 Vault。
3. project_*:專案單一事實來源
專案程式碼可能在 GitHub,但技術架構選型、API 協議合約與交付驗證標準,一律以 Vault 內的 Markdown 為準。
4. Inbox/ 暫存隔離機制
AI 剛總結的經驗不一定 100% 正確。不確定的推論先寫入 Inbox/,經人類定期審查確認具備長期複利價值後,才升級進入 Memory/,避免記憶庫被垃圾資訊稀釋。
工作流閉環:規劃 ➔ 執行 ➔ 交付 ➔ 復盤寫回
這套系統不只是被動查閱,而是嵌入了「任務全生命週期」的自動化循環:
┌─────────────────────────────────────────────────────────────┐
│ 1. 開工前 (Pre-flight Check)                                │
│    AI 讀取 Rules.md + INDEX.md + 相關 feedback_*.md         │
│    確認邊界限制,避免重複犯下已知錯誤                       │
└──────────────────────────────┬──────────────────────────────┘
                               │
                               ▼
┌─────────────────────────────────────────────────────────────┐
│ 2. 執行中 (In-flight Execution)                             │
│    嚴格依循 Vault 既有檔案結構操作,禁止自行亂創無意義根目錄 │
│    遇到架構衝突時,以 Vault 內的文件合約為最終裁決依據      │
└──────────────────────────────┬──────────────────────────────┘
                               │
                               ▼
┌─────────────────────────────────────────────────────────────┐
│ 3. 交付後 (Post-delivery Writeback)                         │
│    將給人看的文件(報告/文章)與原始數據(JSON/截圖)一併歸檔│
│    提煉本次新踩的坑,以 feedback 格式寫回 Inbox 或 Memory   │
└─────────────────────────────────────────────────────────────┘
避坑指南:工程團隊治理 Obsidian 的 4 個鐵律
- 嚴禁無意義的隨機新增目錄:
AI 很容易在根目錄亂建資料夾(如
temp/,test/,output/)。必須在入口規範(如CLAUDE.md)中宣告:「嚴格限制目錄結構,新增目錄前必須確認是否符合既有業務分類」。 - 大檔與個資去識別化(Sanitization): 數百 MB 的原始日誌或錄音檔不應直接塞入 iCloud 同步的 Vault 中,應保留在本機儲存庫,在 Vault 內僅保留精確路徑指標(Pointer)與摘要;且任何客戶機敏資料(個資、金鑰)在進庫前必須強制去識別化。
- 主動歸檔舊版本(Archive Discipline):
反覆迭代容易產生多個類似檔名的交付物。AI 必須主動標記過期版本為
[ARCHIVED],避免後續 Agent 讀取到過期的廢棄協議。 - Frontmatter 嚴格規格化:
所有文章與記憶卡片一律強制帶有標準 YAML Frontmatter(包含
name,type,updated等),讓檢索工具能以毫秒級完成篩選,不浪費上下文視窗。
常見問答 (FAQ)
Q1:為什麼不直接用向量資料庫(Vector DB / RAG)而用 Markdown 檔案?
向量檢索適合泛搜尋,但極度不適合需要精準邊界控制與即時維護的規則。純文字 Markdown 具有最高的人類可讀性、零維護成本、且可直接透過 Git 追蹤每一次修改歷史。
Q2:不同 AI 工具(Claude Code、Cursor、Hermes)怎麼共用這顆大腦?
因為它是本機標準資料夾,只要為不同工具配置指向同一 Vault 目錄的 Symlink 或系統指引檔案(例如在各專案 repo 放置指針),所有終端 Agent 就能即時讀取同一個中台記憶。
💡 企業內部 AI 知識庫與工作流建置諮詢:想為您的團隊打造這套高穩定度、不失憶的 Agent 知識中樞?歡迎預約 30 分鐘架構診斷與評估。