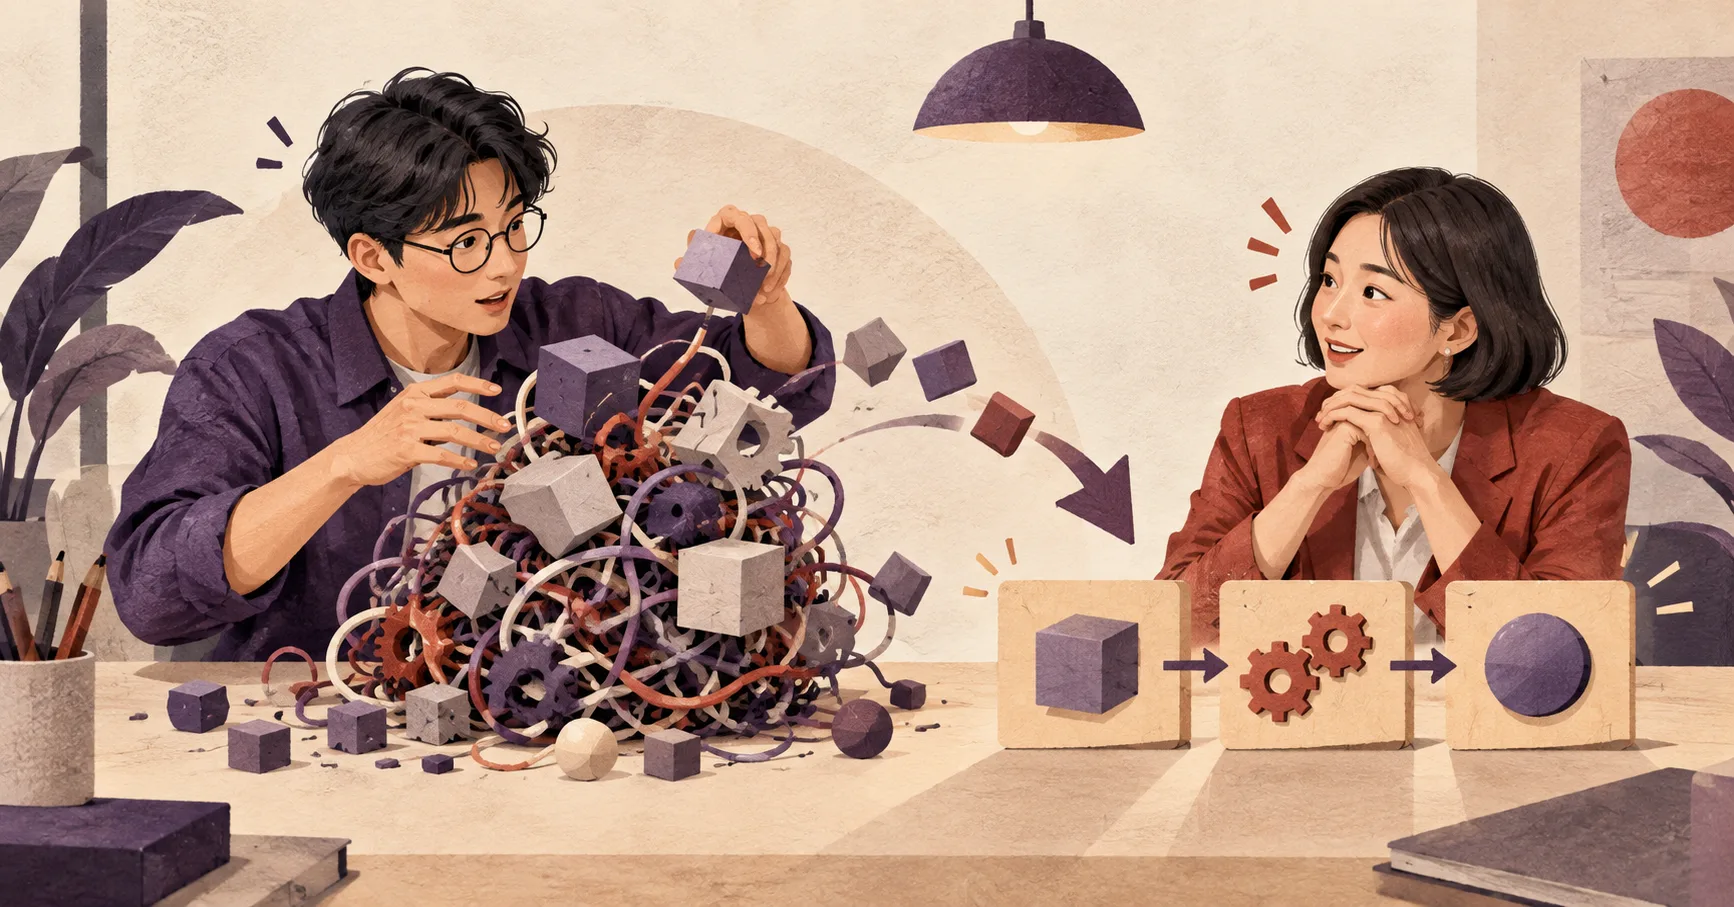
很多工程師跟非技術主管溝通時,最常遇到的挫折不是技術做不出來,而是「你講了一堆底層架構,老闆只覺得你在拖時間或找藉口」。GitHub 上的開源專案 DreambigOu/ELI5(MIT 授權)是一個 Claude Code ELI5(Explain Like I'm 5)Skill,正好可以拿來處理這個工程溝通斷層。本文拆解它的受眾校準方式,並說明它附帶的自動化 Eval 怎麼檢查 AI 輸出的穩定度。
先講結論:ELI5 不是「把人當笨蛋」,而是「語意維度(Framing)的精準校準」
傳統大家對「ELI5(像對五歲小孩一樣解釋)」的誤解,是以為只要「用幼稚的口氣說話」。但真實職場中,非技術溝通的核心在於維度轉換:
- 對工程師:關心資料結構、並發控制、時間複雜度與例外處理。
- 對主管/老闆:關心商業衝擊(Revenue/Cost)、交付風險(Risk)與優先級(Trade-off)。
- 對產品/設計師:關心使用者體驗(UX)、邊界狀態(Edge Case)與互動流暢度。
如果工程師直接把終端機或 PR 的技術名詞丟給主管,結果往往是無效會議。ELI5 Skill 的價值,就是讓開發者在 CLI 終端內敲一行指令,即可將當前的程式碼、架構或報錯,自動翻譯成對應角色的母語。
對象校準矩陣:ELI5 Skill 是如何自動切換視角的?
依照 repo 的 README,這個 Skill 會從 Prompt 判斷對象,再調整五個面向:詞彙(Vocabulary)、比喻(Analogies)、語氣(Tone)、深度(Depth)與溝通焦點(Framing)。對象分成四類:年齡(Ages)、年級(Grade Levels)、職務(Job Roles)、關係(Relationships);沒有指定對象時,預設是「5 歲」。
下面這張表是我參考 SKILL.md 各類別的說明,挑工程師最常遇到的幾種對象自己整理的中文摘要,不是原文翻譯:
| 對象(SKILL.md 類別) | 溝通焦點 (Framing) | 詞彙與比喻 (Vocabulary / Analogies) | 語氣 (Tone) |
|---|---|---|---|
| 主管 Manager(職務) | 影響、時程、風險、成本:講商業結果、對團隊的影響、需要他做什麼決定 | 先講影響,能量化就量化,沒被問到就不講實作細節 | 有把握、清楚,尊重對方的判斷 |
| 總監 Director(職務) | 策略、ROI、競爭優勢:講大局、市場定位、資源配置 | 同上,以商業語言為主 | 有把握、清楚 |
| 設計師 Designer/產品經理 Product Manager(職務) | 使用者體驗與範圍:對使用者的影響、互動流程;功能價值、優先順序、做什麼與不做什麼 | 用使用者旅程、互動模式、使用者故事來說明 | 協作導向 |
| 工程師 Engineer(職務) | 運作方式、架構、取捨:實作、效能、可維護性 | 用正確術語,重點放在取捨與邊界情況,可以拿他已經熟悉的東西類比 | 精簡,尊重既有知識 |
| 伴侶、父母、朋友(關係) | 生活直覺理解 | 0 技術黑話;用家務、日常、他們熟悉的科技或共同興趣來比喻 | 溫暖、耐心、不居高臨下 |
| 5 歲(年齡,預設對象) | 抓到核心概念就好 | 玩具、動物、遊樂場這類比喻,短句 | 熱情,像小朋友喜歡的老師 |
實戰對比範例:解釋「資料庫索引(Database Index)」
以下是我自己舉的例子,不是 repo 裡的範例:
- 工程師原始技術語言:「這是一個建立在特定欄位上的 B-Tree 索引結構,能將檢索時間從 O(N) 降低到 O(log N)。」
- 轉換給主管聽:「現在系統找一筆訂單要花 3 秒翻完整張表;加了索引就像給帳冊加上快速標籤頁,查詢能在 0.05 秒內完成,伺服器費用也不會因為促銷爆量而飆高。」(數字為示意)
架構拆解:如何為 Claude Code 撰寫並安裝 ELI5 Skill?
Claude Code 的 Skill 機制非常輕量,本質上就是透過 Markdown 規範將特定角色與輸出約定注入當前工作階段:
1. 安裝方式
在終端機中將 Skill 放置於使用者家目錄的 Claude 配置資料夾:
git clone https://github.com/DreambigOu/ELI5.git
cp -r ELI5/skills/eli5 ~/.claude/skills/eli5
2. 日常終端呼叫情境
安裝完成後,在日常使用 Claude Code 重構、除錯或寫 PR 時,可以直接在終端機輸入:
# 讓 AI 幫你寫一段給主管看的工作進度總結
> Explain this git diff to my manager

# 把複雜的非同步競態條件解釋給設計師聽
> Explain why this race condition affects the UI to our designer

# 把重構原因白話化
> ELI5 why we need to rewrite this authentication middleware
品質工程實務:如何用 Eval(評測系統)檢查 AI 解釋有沒有失真?
許多 Prompt 常常是「感覺很厲害,但換個案例就翻車」。ELI5 專案中最值得工程團隊借鏡的,是它附帶的 自動化評測(Eval System)。
1. 斷言測試結構(Assertions)
在 eli5-workspace/evals.json 中,每個測試案例都定義 4 條具體、可驗證的判斷準則。以下節錄 repo 裡的一個測試案例(主管對象):
{
  "id": 1,
  "name": "explain-codebase-manager",
  "prompt": "Explain a typical web application codebase's structure to my manager",
  "audience": "Manager",
  "assertions": [
    "Contains no code blocks or inline code formatting — purely prose",
    "Frames explanation in business terms: mentions impact, decisions, risk, timeline, or team capacity",
    "Response is under 500 words — concise enough for a busy manager",
    "Includes at least one actionable recommendation or decision point for the manager"
  ]
}
2. 對比 Baseline 的評測結果
以下數字來自 repo 的 README(MIT 授權,2026-10-02 查閱),是作者自己跑的評測。評測腳本(eli5-workspace/run-evals.py)把每個 Prompt 各跑兩次,一次掛 Skill、一次不掛(Baseline),再用 Claude 依斷言自動評分。README 公布的是 12 條斷言的通過率(evals.json 目前有 3 個測試案例,每個 4 條):
- Baseline(不掛 Skill):12 條通過 5 條,README 寫 41.6%。README 的範例輸出裡,Baseline 被扣分的原因之一是語氣太像百科全書。
- 掛上 ELI5 Skill:12 條通過 10 條,83.3%。README 提到改善最明顯的是非技術對象的溝通框架,例如主管:從 Baseline 的 0% 到掛上 Skill 後的 50%。
同一個 repo 的 eli5-workspace/eval-results.md 另外記錄了一輪結果,是 91.7% 對 33.3%。兩份數字不一樣,也說明 12 條斷言是很小的樣本,跑一次的結果會有波動。
所以在這個小樣本裡,能看到的是一個趨勢,不是定論:把溝通標準寫成 Skill、再搭配評測斷言,輸出會比較穩定,也比較容易看出哪裡還不夠好。
常見問答 (FAQ)
Q1:在 Hermes Agent 或其他開源 Agent 系統中能使用類似機制嗎?
可以。Prompt 核心是通用的受眾矩陣與 Framing 策略。Hermes Agent 可以透過 skill_manage 工具建立自己的 Skill(見 Hermes Agent 的 Skills 文件),你可以把受眾矩陣寫成一個 eli5-explainer Skill,用在需要撰寫交付文件或客戶溝通的流程上。
Q2:使用比喻(Metaphor)時,會不會導致技術事實被過度扭曲?
會,所以評測斷言裡最好放一條「概念解釋正確」。README 示範新增測試案例時,就有一條類似的斷言:「Correctly explains the concept of a function calling itself」。好的 ELI5 比喻必須包含「邊界說明」——例如在講資料庫快取時,比喻成辦公桌放常用文件,但也必須順帶說明「如果文件過期需要清空(Cache Invalidation)」的代價。
💡 打造團隊專屬的 Agent 溝通產線:如果您也希望為公司內部建立客製化的 AI Agent 溝通規範與評測工作流,歡迎透過下方表單或預約諮詢與我交流。