當使用者在 ChatGPT 輸入「推薦適合中小企業的 AI 導入顧問」或「比較兩款企業自動化架構」時,AI 是如何決定推薦誰、引用誰的?賣實體產品要進 Google Merchant Center (GMC) 或 OpenAI Product Feed,但賣專業服務、系統整合與軟體開發的 B2B 企業,該如何建立自己的 AI 搜尋可見度(GEO)?
先講結論:ChatGPT 搜尋與推薦不是「即時爬全站」,而是三層資料過濾
許多企業主與行銷團隊常誤以為「只要網站在 Google 能被搜尋到,ChatGPT 或 Perplexity 就會自動抓取並推薦」。在實際的搜尋引擎與 LLM 檢索架構中,這完全是兩個不同的運作邏輯。
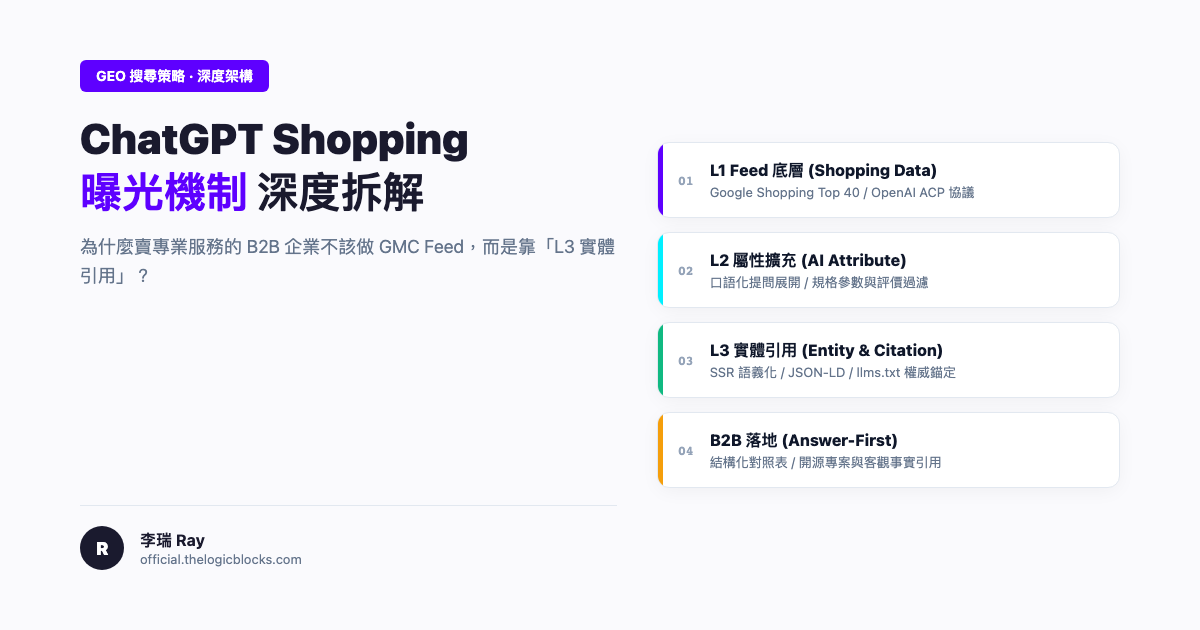
AI 搜尋引擎(如 ChatGPT Search / Shopping 模組)的推薦機制可精確拆解為以下三層架構:
| 層級 | 核心機制 | 適用對象 | 資料來源與技術要求 |
|---|---|---|---|
| L1 Feed 底層 (結構化資料源) | 打 Google Shopping 有機前 40 名資料或商家主動推播之 OpenAI Product Feed (ACP 協議) | 實體商品、電商賣家 | GMC 產品目錄、庫存 API、即時價格 (非一般網頁內文) |
| L2 屬性擴充 (AI Attribute Layer) | 將使用者口語化提問透過 Fanout 查詢自動展開為專業屬性標籤 | 產品與規格化服務 | 規格參數表、結構化屬性、用戶真實評分 (低於 3 星直接過濾) |
| L3 開放網路聲譽 (Entity & Citation) | 透過全網爬蟲、權威評測、技術文件、論壇與社群建立「實體 (Named Entity) 關聯」 | B2B 企業、顧問與專業服務商 | 深度技術文章、JSON-LD 結構化資料、llms.txt、第三方引用背書 |
核心結論:
- 賣實體產品:GMC Feed 與電商通路品質是進入 AI 購物推薦的開關。
- 賣專業服務(顧問、系統開發、B2B 方案):完全沒有 Feed 機制可推,唯一被 AI 檢索與引用的路徑就是 L3 實體引用(GEO + 語義結構化 + 第三方權威提及)。
產品電商 vs 專業服務業:AI 搜尋生存策略對照
| 維度 | 實體產品電商 (Product Search) | 專業服務 / B2B 系統 (Service GEO) |
|---|---|---|
| 曝光入口 | 購物卡片、比價清單、即時結帳按鈕 | AI 生成回答中的推薦段落、方案優劣對比、引用來源連結 |
| 決定勝負的關鍵 | 價格競爭力、現貨庫存、評分 > 4.0、Feed 欄位齊全度 | 技術深度 (E-E-A-T)、實體一致性 (Entity Consistency)、Answer-First 明確定義 |
| 最容易犯的錯誤 | 只有行銷宣傳圖,缺少文字規格參數 | 通篇行銷空話與罐頭標語,缺少可被 LLM 萃取的架構表與定價邊界 |
| AI 引用抓取來源 | Google Shopping、Amazon、官方 Merchant Feed | 官方技術部落格、白皮書、案例庫、第三方報導、GitHub / 開源資產 |
B2B 企業官網要被 AI 搜尋引用,技術底層必須通過的 4 道檢查
以我們實際對現代企業官網進行 AI 可見度體檢的工程經驗,一個能被 AI 爬蟲(GPTBot、PerplexityBot、ClaudeBot)有效解析的網站,必須具備以下 4 個工程特徵:
1. 真正的伺服器端渲染 (SSR / SSG),拒絕純客戶端 SPA
大型語言模型的爬蟲為了節省算力與資源,對執行繁重 JavaScript 的客戶端 SPA(如未經 SSR 的 React 應用)往往抓取不全或直接略過。
- 標準要求:首頁、方案頁、部落格與案例頁的核心內文與結構,必須直接存在於原始 HTML 原始碼中(Next.js RSC Payload 或靜態 HTML)。
2. 精確且完整的 JSON-LD 語義標記 (Schema.org)
不要只放最基礎的 WebSite 標記。專業 B2B 網站應標配:
Organization與Person:定義企業法人與技術專家實體。ProfessionalService與Offer:清楚標記服務項目、交付範圍與幣別定價。FAQPage:提供 Answer-first 問答對,爬蟲會直接提取作為問答知識塊。
3. llms.txt 開發者與 Agent 友善索引
在網站根目錄提供 /llms.txt 與 /llms-full.txt,用極簡 Markdown 明確陳述:
- 企業核心定位與服務項目
- 關鍵產品 API 規格或服務交付流程
- 核心案例庫連結與公開定價架構
4. Answer-First 寫作結構與 Markdown 對比表格
AI 爬蟲不會閱讀鋪陳 500 字的心態心法。每段 H2 標題下方,第一句話必須在 40~60 字內直接給出客觀定義,隨後緊接著結構化表格。這種結構最容易被 RAG(檢索增強生成)直接切片收錄。
為什麼你的網站技術做滿了,AI 還是不推薦你?——「實體聲譽」缺口
許多技術主管向我們反映:「我們的網站 SSR 做了、Schema 寫了、Sitemap 也全綠,為什麼問 ChatGPT 推薦廠商時依然沒有我們?」
這是因為 「網站內部可控的技術層」只是入場門票,真正觸發 AI 推薦的是「外部實體提及(Entity Co-occurrence)」:
- 網域年齡過新(例如剛上線 6 個月內)
- 網路上缺乏第三方權威論壇、技術社群或媒體報導提及你的品牌與特定專業領域的關聯
- 沒有公開可驗證的開源專案、具名案例或產業白皮書
破局之道:持續產出具備「第一手實戰踩坑數據」與「架構決策表」的旗艦技術資產,讓同業、開發者與專業社群主動引用。當開放網路上大量出現「品牌名稱 + 特定解決方案」的共現關聯,AI 搜尋的推薦權重才會真正被啟動。
常見問答 (FAQ)
Q1:B2B 企業需要去申請 OpenAI 的 Product Feed 嗎?
不需要。OpenAI Product Feed 與 ACP 即時結帳協議目前主要面向實體消費品與標準化電商。B2B 企業與專業顧問服務應專注於 L3 實體引用與 GEO 結構化內容建設。
Q2:傳統 SEO 與 GEO(AI 搜尋優化)最大的差異是什麼?
傳統 SEO 的目標是「讓網頁在特定關鍵字出現在 Google 搜尋前 10 名藍色連結」;GEO 的目標是「讓 AI 在整合數十個來源回答複雜問題時,將你的架構、數據或方案作為權威答案直接引用」。
💡 企業官網 AI 可見度體檢:想確認您的企業官網是否具備完整的 SSR、JSON-LD、llms.txt 與 GEO 結構化資料?歡迎使用我們的免費線上檢測工具或預約架構諮詢。